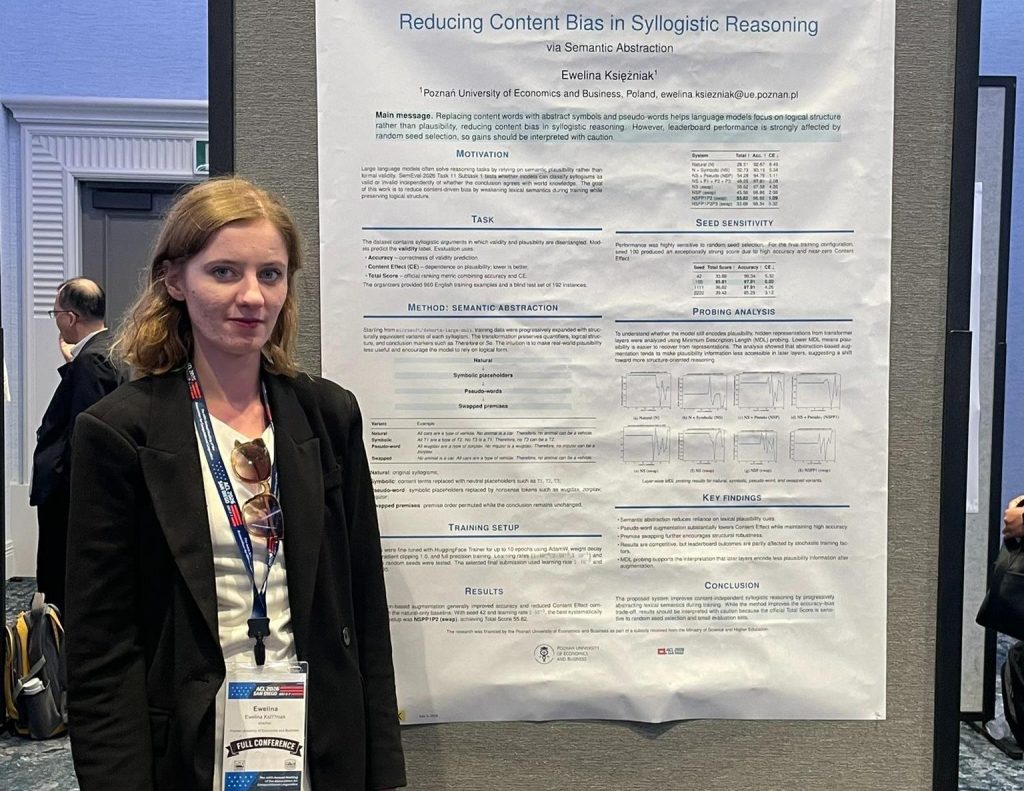
Podczas międzynarodowej konferencji ACL 2026 w San Diego w Stanach Zjednoczonych Ewelina Księżniak zaprezentowała wyniki badań nad ograniczaniem wpływu treści na wnioskowanie logiczne dużych modeli językowych. Badania zostały przedstawione w formie posteru na podstawie artykułu pt. „Team ewelinaksiez at SemEval-2026 Task 11: Reducing Content Bias in Syllogistic Reasoning via Semantic Abstraction”.
Praca powstała w ramach zadania 11 konkursu SemEval-2026, którego tematem było oddzielenie wpływu treści argumentów od ich formalnej poprawności logicznej w procesie wnioskowania dużych modeli językowych. Badanie dotyczyło jednego z istotnych problemów współczesnej sztucznej inteligencji: czy modele językowe rzeczywiście potrafią rozumować logicznie, czy też ich odpowiedzi zależą od posiadanej wiedzy o świecie i semantycznej wiarygodności przedstawionych argumentów?
Zaproponowana metoda polegała na stopniowym zastępowaniu słów w zdaniach abstrakcyjnymi symbolami i sztucznie wygenerowanymi wyrazami, przy jednoczesnym zachowaniu struktury logicznej argumentów. Uzyskane wyniki pokazały, że takie podejście pozwala ograniczyć wpływ treści na decyzje modelu i poprawić skuteczność rozumowania. Dodatkowa analiza wewnętrznych reprezentacji modelu pozwoliła zbadać, w jaki sposób przetwarza on informacje związane z semantyczną wiarygodnością argumentów.
Zgłoszone rozwiązanie zajęło 12. miejsce w oficjalnym rankingu konkursu, przy czym pierwszych 11 systemów uzyskało identyczny wynik. Wyniki badań wskazują zarówno na możliwości ograniczania błędów poznawczych modeli językowych, jak i na wyzwania związane ze stabilnością ich oceny. Pełna treść publikacji jest dostępna na stronie ACL Anthology. DOI: 10.18653/v1/2026.semeval-1.272
Konferencja ACL 2026 (Annual Meeting of the Association for Computational Linguistics) odbyła się w dniach 2–7 lipca 2026 r. w San Diego w Stanach Zjednoczonych. Jest to jedno z najważniejszych międzynarodowych wydarzeń naukowych poświęconych przetwarzaniu języka naturalnego i lingwistyce komputerowej, gromadzące badaczy z całego świata.