Automatyczne tworzenie baz wiedzy z wykorzystaniem dużych modeli językowych

W otwartym dostępie ukazała się publikacja pt. „Pre-training Aware Directed Reasoning for Closed-Book Knowledge Base Construction”, autorstwa mgra Mikołaja Tyma, pracownika naszej Katedry. Praca przedstawia metodę wykorzystującą duże modele językowe do automatycznego uzupełniania baz wiedzy. Publikacja została zaprezentowana podczas międzynarodowej konferencji EMNLP 2026, która się odbyła w dniach 24-29 października 2026 roku w Budapeszcie.
Czy duże modele językowe mogą zastąpić ludzkich anotatorów? Praca naszych naukowców na konferencji EMNLP 2026

W dniach 24–29 października 2026 r. w Budapeszcie odbyła się konferencja EMNLP 2026 (Conference on Empirical Methods in Natural Language Processing). Jest to jedno z najważniejszych międzynarodowych wydarzeń naukowych poświęconych przetwarzaniu języka naturalnego. Podczas konferencji dr Milena Stróżyna przedstawiła artykuł pt. „Multi-Model Framework for Sentiment Annotation: A Use Case of Multilingual Wikipedia”. Praca prezentuje podejście wykorzystujące kilka modeli sztucznej inteligencji jako niezależnych anotatorów, których zgodność pozwala wyznaczać wiarygodne etykiety wydźwięku … Więcej informacji

SKN Data Science: spotkanie inauguracyjne 2026/2027

22 października 2026 r. odbyło się spotkanie inauguracyjne SKN Data Science, podczas którego przedstawiono plany działalności oraz najważniejsze kierunki rozwoju studenckiego koła naukowego w roku akademickim 2026/2027. W najbliższych miesiącach działalność koła będzie koncentrować się na rozwijaniu praktycznych umiejętności z zakresu analizy danych, programowania w języku Python oraz sztucznej inteligencji.

ACL 2026: sukces w międzynarodowym konkursie analizy podobieństwa narracji

Rozwiązanie opracowane przez naszego naukowca zajęło drugie miejsce w międzynarodowym konkursie analizy podobieństwa narracyjnego SemEval-2026. Jego autor, mgr Marcin Sawiński, zaprezentował wyniki badań podczas konferencji ACL 2026 w Stanach Zjednoczonych, jednym z najważniejszych międzynarodowych wydarzeń w dziedzinie przetwarzania języka naturalnego.

Ograniczanie wpływu treści na wnioskowanie sylogistyczne dużych modeli językowych

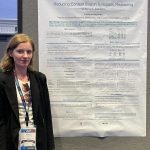
Podczas międzynarodowej konferencji ACL 2026 w San Diego w Stanach Zjednoczonych mgr Ewelina Księżniak zaprezentowała wyniki badań nad ograniczaniem wpływu stronniczych treści na wnioskowanie sylogistyczne dużych modeli językowych. Badania zostały przedstawione w formie posteru na podstawie artykułu pt. „Team ewelinaksiez at SemEval-2026 Task 11: Reducing Content Bias in Syllogistic Reasoning via Semantic Abstraction”.

Sztuczna inteligencja w analizie wydźwięku wielojęzycznej Wikipedii: klasyfikatory kontra duże modele językowe

W otwartym dostępie ukazała się publikacja pt. „Evaluating Multilingual Sentiment Classifiers Using an LLM-Annotated Wikipedia Benchmark”, której autorami są pracownicy naszej Katedry: dr Milena Stróżyna, dr Włodzimierz Lewoniewski, mgr Izabela Czumałowska. Praca została zaprezentowana podczas konferencji ACL 2026 w San Diego, która odbyła się w dniach 2-7 lipca 2026 roku.

Prezentacja na konferencji EACL 2026

W dniach 24-29 marca 2026 roku mgr Ewelina Księżniak wzięła udział w konferencji EACL 2026 (19th Conference of the European Chapter of the Association for Computational Linguistics) – jednej z najważniejszych europejskich konferencji naukowych w dziedzinie przetwarzania języka naturalnego, gromadzącej badaczy zajmujących się m.in. lingwistyką komputerową, sztuczną inteligencją i analizą tekstu. Tegoroczna edycja konferencji odbyła się w Rabacie w Maroko.

Analiza neutralności Wikipedii z wykorzystaniem sztucznej inteligencji

Artykuł autorstwa naszych naukowców pt. „Cross-Topic Sentiment Analysis of Wikipedia Articles: A Comparative Study of AI Models” został opublikowany. Praca koncentruje się na jednym z fundamentów Wikipedii – zasadzie neutralnego punktu widzenia, która zakłada bezstronne przedstawianie informacji. Publikacja ta pokazuje, jak nowoczesne metody AI mogą wspierać analizę jakości informacji w skali globalnej, jednocześnie ujawniając złożoność i wyzwania stojące za pojęciem „neutralności”.

Trendy badawcze w technologii blockchain i kryptoaktywach

Praca autorstwa naszych naukowców poświęcona analizie trendów badawczych w obszarze technologii blockchain oraz kryptoaktywów została opublikowana w otwartym dostępie na stronie wydawnictwa Elsevier. Badanie dotyczy analizy ponad 50 tysięcy prac naukowych z lat 2015–2025, a wyniki dostarczają unikalnego, opartego na danych obrazu tego, jak ewoluują badania nad blockchainem.

Prezentacje naukowe: od trendów w blockchainie po jakość wizualizacji w Wikipedii

Podczas międzynarodowej konferencji naukowej KES 2025 zostały zaprezentowane prace autorstwa naszych pracowników z wynikami badań nad ewolucją trendów naukowych w obszarze technologii blockchain oraz nad jakością i dystrybucją wizualizacji danych w polskojęzycznej Wikipedii.