W dniach 24–29 października 2026 r. w Budapeszcie odbyła się konferencja EMNLP 2026 (Conference on Empirical Methods in Natural Language Processing). Jest to jedno z najważniejszych międzynarodowych wydarzeń naukowych poświęconych przetwarzaniu języka naturalnego. Podczas konferenceji dr Milena Stróżyna przedstawiła artykuł pt. „Multi-Model Framework for Sentiment Annotation: A Use Case of Multilingual Wikipedia”. Praca prezentuje podejście wykorzystujące kilka modeli sztucznej inteligencji jako niezależnych anotatorów, których zgodność pozwala wyznaczać wiarygodne etykiety wydźwięku tekstu.
Ręczne oznaczanie danych tekstowych jest kosztowne i czasochłonne, dlatego coraz częściej wykorzystuje się do tego duże modele językowe (LLM). Ich odpowiedzi bywają jednak niestabilne i zależne od konkretnego modelu. Autorzy zaproponowali podejście, w którym kilka modeli pełni rolę niezależnych anotatorów. W badaniu każdy z trzech modeli (GPT-5.2, Gemini 3.1 Pro, Claude Opus 4.6) oceniał wydźwięk zdań trzykrotnie. Etykieta była uznawana za wiarygodną tylko wtedy, gdy wszystkie dziewięć ocen było zgodnych. Metodę sprawdzono na zdaniach pochodzących z abstraktów artykułów Wikipedii w pięciu językach: angielskim, niemieckim, hiszpańskim, polskim i rosyjskim.
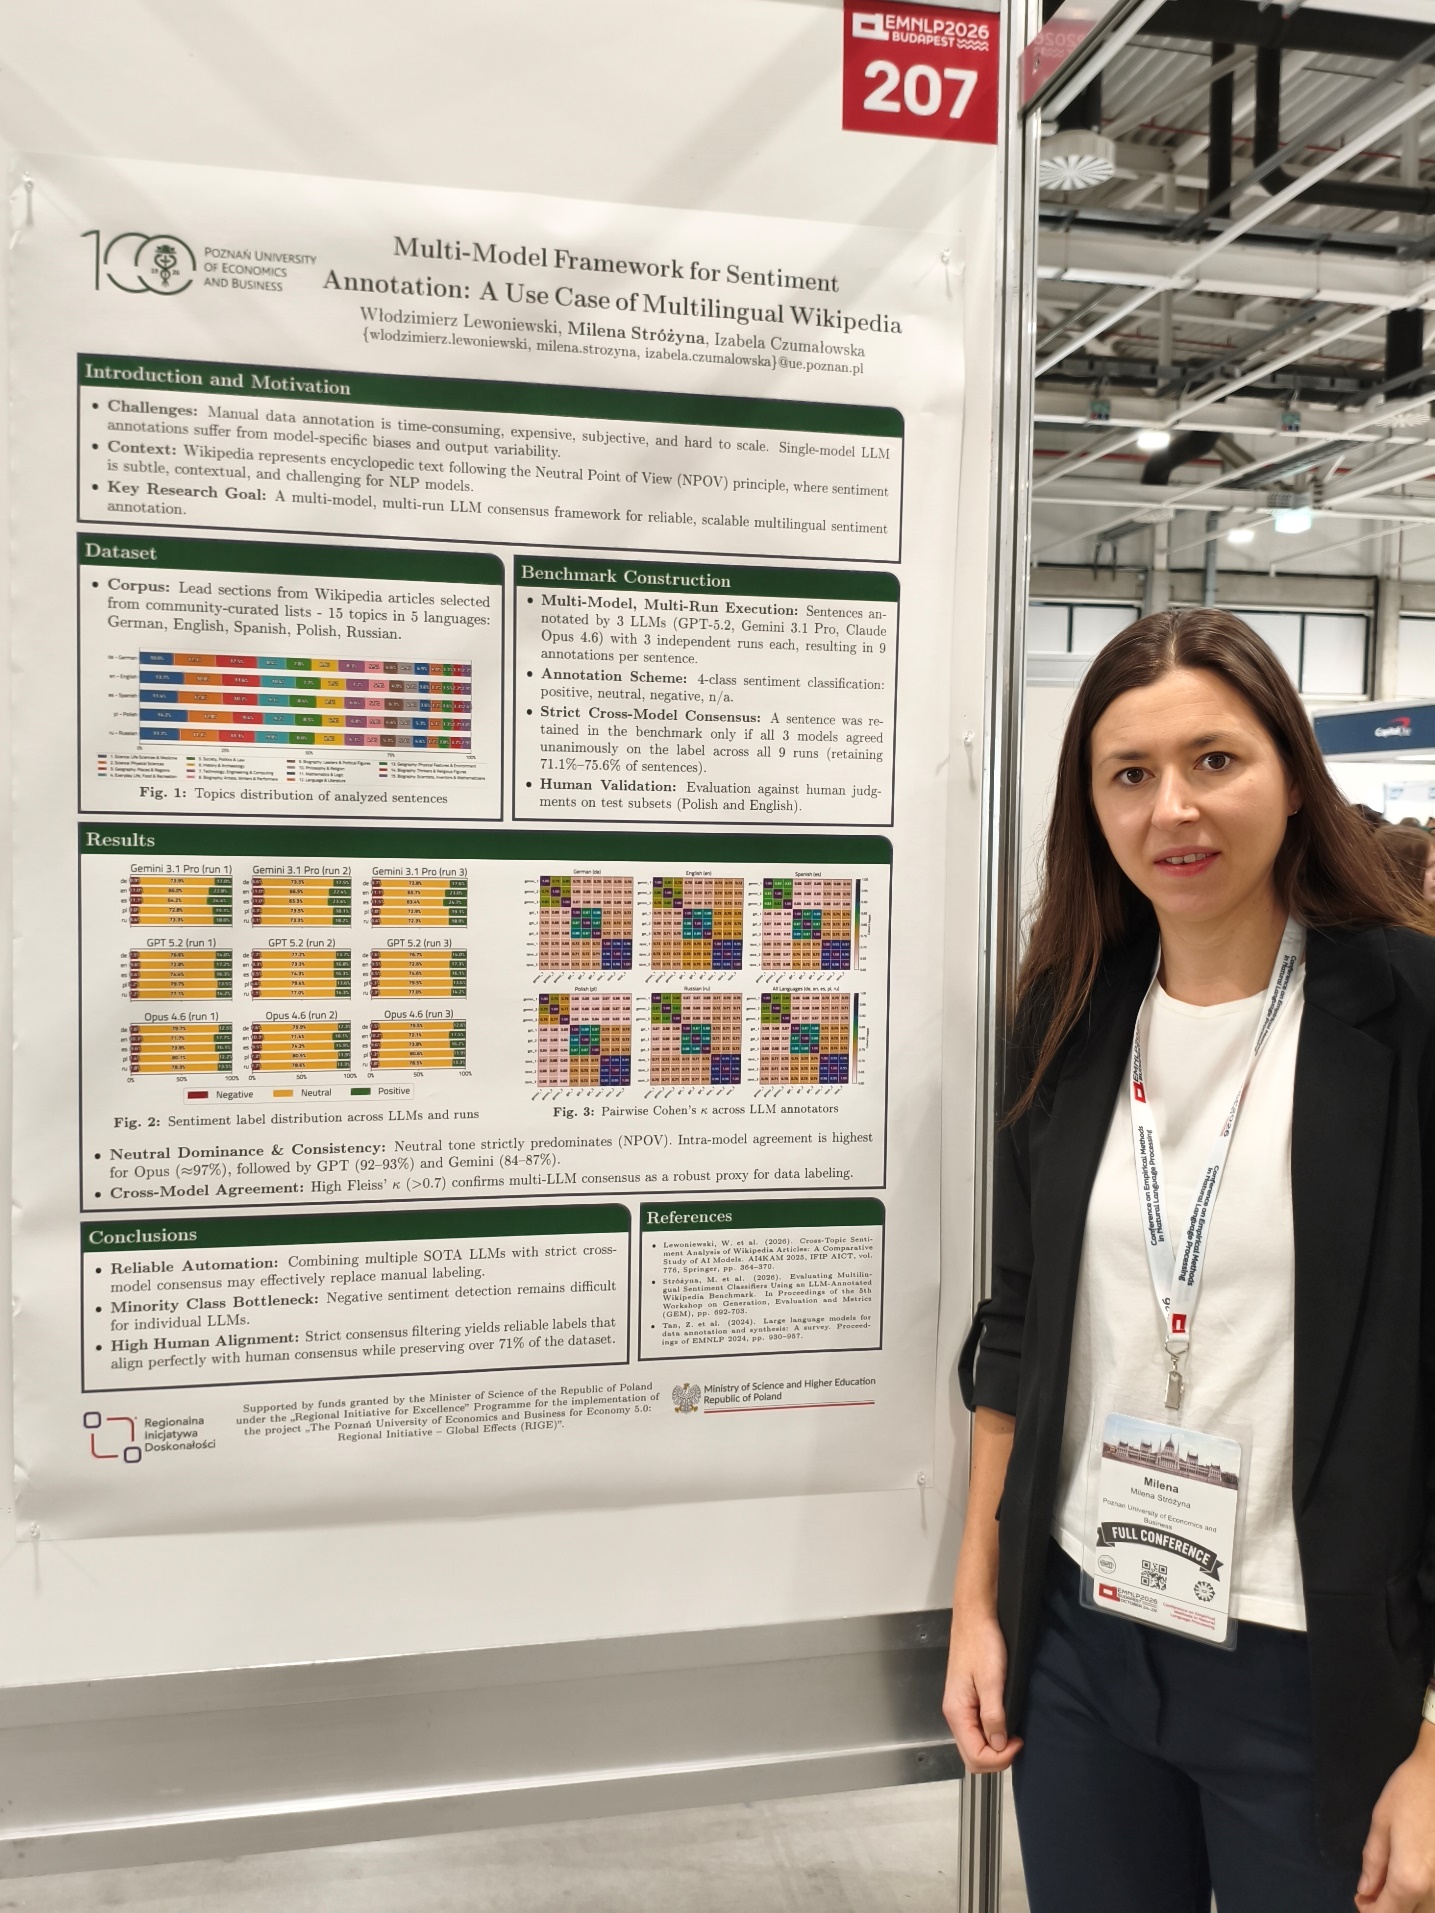 Pełna zgodność wszystkich przebiegów dotyczyła od 71% do 76% zdań, w zależności od języka. Współczynnik Fleissa κ wyniósł od 0,72 do 0,76. W przypadku zdań, co do których modele były zgodne, etykiety w pełni pokryły się z ocenami ludzi. Analiza pokazała też ograniczenia – modele wyraźnie gorzej radzą sobie z rozpoznawaniem wydźwięku negatywnego. W efekcie powstał wielojęzyczny zbiór ok. 75 tys. zdań z etykietami wydźwięku. Został on udostępniony publicznie w serwisie Hugging Face, aby wspierać skalowalne i powtarzalne adnotowanie danych.
Autorzy publikacji: dr Włodzimierz Lewoniewski, dr Milena Stróżyna oraz mgr Izabela Czumałowska. Pełny tekst artykułu jest dostępny na stronie ACL Anthology. DOI: 10.18653/2026.findings-emnlp.1830
EMNLP to coroczna konferencja organizowana przez SIGDAT, grupę tematyczną ACL (Association for Computational Linguistics). Należy do najbardziej prestiżowych konferencji w dziedzinie przetwarzania języka naturalnego i ma najwyższą kategorię A* w rankingu CORE. Tegoroczna edycja odbyła się w centrum kongresowo-wystawienniczym Hungexpo w Budapeszcie.